Como estruturar aulas em markdown, gerar sínteses técnicas com IA, e criar conexões semânticas automáticas no grafo de conhecimento.
Na última segunda-feira (28/09/2026), iniciei a formação prática do Tech Leads Club - Elevate. Era um treinamento que eu já planejava fazer há algum tempo, tanto pela profundidade técnica nas aplicações práticas de Inteligência Artificial quanto pela oportunidade de trocar experiências com uma comunidade ativa de engenheiros e líderes técnicos.
Com o início das aulas, me deparei com um desafio prático de rotina: além dos encontros ao vivo, a plataforma disponibiliza dezenas de cursos gravados no ambiente da comunidade. Como eu não consigo fixar bem conteúdos técnicos apenas assistindo passivamente a vídeos sem anotar, estruturar e praticar, decidi desenvolver o course2brain.
O registro manual tradicional apresenta três gargalos frequentes:
- Interrupção de raciocínio: pausar o player continuamente para transcrever falas ou copiar termos prejudica a absorção do conteúdo.
- Isolamento de notas: documentos lineares em editores tradicionais ou pastas locais acumulam texto, mas não cruzam referências entre diferentes temas.
- Fragmentação de fontes: o que foi aprendido sobre IA em um curso fica desconectado de anotações anteriores sobre arquitetura de software, observabilidade ou bancos de dados.
O course2brain automatiza esse fluxo: com um clique na página da aula, ele extrai o conteúdo, gera sínteses técnicas estruturadas com o modelo de IA que você escolher (OpenRouter com modelos gratuitos, Gemini, OpenAI, Grok ou Ollama local) e grava notas atômicas diretamente no cofre do Obsidian, criando conexões semânticas automáticas no grafo de conhecimento (metodologia Second Brain / Zettelkasten).
O projeto é open source e está disponível no GitHub: github.com/thyagoluciano/course2brain.
Arquitetura da solução
O sistema é composto por três partes integradas:
[ Navegador: Página da Aula ]
            │
            ▼ (1 Clique)
┌─────────────────────────────────────────────────────────────┐
│ 1. EXTENSÃO CHROME (Manifest V3)                            │
│    Extrai título, legendas (WebVTT/SRT), notas e links      │
└─────────────────────────────┬───────────────────────────────┘
                              │ HTTP POST :8765
                              ▼
┌─────────────────────────────────────────────────────────────┐
│ 2. MOTOR LOCAL (FastAPI + Typer CLI)                        │
│    • Normalização de legendas e deduplicação de texto       │
│    • Síntese estruturada via LLM (OpenRouter, Gemini)       │
│    • Gravação atômica da nota e atualização de MOCs         │
│    • Indexação vetorial em SQLite e busca por cossenos      │
│    • Validação de conexões com IA (Auto-Interlink)          │
└─────────────────────────────┬───────────────────────────────┘
                              │
                              ▼
┌─────────────────────────────────────────────────────────────┐
│ 3. COFRE OBSIDIAN (Second Brain)                            │
│    Notas atômicas padronizadas e nós interligados no Grafo  │
└─────────────────────────────────────────────────────────────┘
1. Extensão Chrome (Manifest V3)
Injetada na página da aula, a extensão utiliza seletores em cascata para identificar título, legendas embutidas em tags <track> (inclusive blobs carregados em memória), descrições de texto e links externos para referências citadas pelo professor. Hoje há extratores para Circle.so, Skilljar (usado, por exemplo, em cursos de parceiros da Anthropic) e Udacity, com suporte extensível via padrão Strategy.
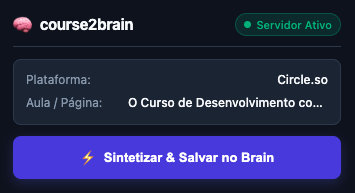
Nas plataformas que organizam o conteúdo em espaços, módulos e seções, a extensão também lê essa hierarquia e numera módulos e aulas conforme a ordem do currículo na página. Quando a aula não tem legenda disponível e o vídeo é do YouTube, o motor busca a transcrição do próprio vídeo. O popup mostra o andamento de cada etapa (extração, síntese, gravação e interlink).
2. Motor Local em Python (c2b serve)
Um serviço HTTP local rodando na porta 8765 recebe os dados em formato JSON e executa o pipeline:
- Normalização textual: remove marcações temporais e deduplica linhas repetidas de legendas contínuas, gerando parágrafos legíveis. Se a aula não trouxer legendas, usa a transcrição do YouTube como alternativa.
- Síntese orientada a engenharia: o modelo configurado analisa a transcrição e gera uma nota dividida em seções fixas:
- Resumo Executivo (TL;DR): os 3 a 5 pontos centrais da aula.
- Conceitos Fundamentais e Trade-offs: definições técnicas detalhadas, motivos de adoção e cenários onde o padrão não deve ser usado.
- Aplicação Prática: ações objetivas que o profissional pode executar em seu projeto.
- Perguntas de Active Recall: questões reflexivas para autoavaliação futura.
- Referências e Links: repositórios, artigos e documentações citadas pelo instrutor.
- Gravação atômica: o arquivo é gravado em
10-Cursos/<Curso>/<Aula>.md, atualizando automaticamente o índice do curso (MOC), que reflete a hierarquia de espaços e seções quando a plataforma a oferece. A escrita utiliza arquivos temporários no mesmo diretório para evitar conflitos de sincronização no iCloud Drive.
Escolha o modelo: de gratuito a frontier
O motor não depende de um único fornecedor. O provedor padrão é o OpenRouter, que dá acesso a centenas de modelos com uma chave só, incluindo modelos gratuitos (sufixo :free). Também há suporte nativo a Google Gemini, OpenAI, Grok (xAI) e Ollama, para rodar tudo local, offline e sem custo de API.
Os modelos gratuitos que uso e recomendo no guia do projeto:
| Modelo | Contexto | Uso sugerido |
|---|---|---|
google/gemma-4-31b-it:free | 262k tokens | Síntese das aulas: bom português e Markdown bem formatado |
qwen/qwen3.8-27b:free | 262k tokens | Validação do Auto-Interlink: JSON estrito e raciocínio lógico |
nvidia/nemotron-3-ultra-550b-a55b:free | 1M tokens | Aulas longas e transcrições de várias horas |
openrouter/free | 200k tokens | Roteador que escolhe um modelo gratuito disponível |
A configuração mais simples usa um único modelo gratuito para tudo:
[ai]
default_provider = "openrouter"

[openrouter]
# Deixe vazio para ler de OPENROUTER_API_KEY
api_key = "sk-or-v1-..."
model = "google/gemma-4-31b-it:free"
rpm_limit = 15
Também é possível escolher um modelo por tarefa. No exemplo, o Gemma resume as aulas e o Qwen valida as conexões do grafo, ambos gratuitos:
[ai.synthesis]
provider = "openrouter"
model = "google/gemma-4-31b-it:free"

[ai.interlink]
provider = "openrouter"
model = "qwen/qwen3.8-27b:free"
Nada impede de misturar: síntese com um modelo gratuito do OpenRouter e validação do interlink com o Gemini oficial, por exemplo.
Alguns pontos sobre os limites dos modelos gratuitos:
- O teto é de 20 requisições por minuto. O motor tem um limitador interno (
rpm_limit = 15) para ficar abaixo disso. - Contas sem créditos têm 50 requisições gratuitas por dia. Com pelo menos US$ 10 em créditos na carteira, o limite sobe para 1.000 por dia.
- Se o modelo responder com erro de cota, de autenticação ou de indisponibilidade, a mensagem no terminal indica o provedor e o que fazer.
O passo a passo para criar a conta e a chave está em docs/OPENROUTER_GUIDE.md, no repositório.
Auto-Interlink: conectando temas afins no Grafo
A principal funcionalidade do projeto é a criação de conexões semânticas entre aulas de cursos distintos e notas existentes.
Quando uma nova nota é gravada:
- O texto do resumo executivo e conceitos é convertido em um vetor de embeddings (384 dimensões).
- O sistema consulta um banco SQLite local e calcula a similaridade de cossenos com todas as outras notas já indexadas no cofre.
- As notas com similaridade igual ou superior a 0.78 são enviadas ao modelo configurado para o interlink (por exemplo, o Qwen gratuito via OpenRouter) com o objetivo de validar relevância conceitual real.
- Para cada par aprovado, o motor injeta links bidirecionais com justificativas objetivas na seção
## 🔗 Conexões Relacionadas:
## 🔗 Conexões Relacionadas
- [[02 - Kafka Fundamentals]]: Aprofunda a estratégia de mensageria assíncrona citada nesta aula.
- [[Clean Architecture]]: Contextualiza o isolamento de eventos de domínio na camada de aplicação.
No Graph View do Obsidian, essas notas passam a compartilhar arestas visíveis, permitindo navegar entre conceitos correlatos sem depender da estrutura de pastas.
Escopo configurável: conectando artigos, conceitos e notas do cofre
Em um Segundo Cérebro, o conhecimento não fica restrito a aulas gravadas. Há artigos técnicos (como este próprio texto em 50-Conteudo/), notas conceituais atômicas (20-Ideias/) e projetos (30-Projetos/).
Para evitar que notas manuais fiquem isoladas das aulas de cursos, o motor permite configurar no c2b.toml quais diretórios devem participar do índice vetorial:
[interlink]
enabled = true
similarity_threshold = 0.78
max_links = 5

# Pastas relativas ao cofre incluídas na indexação.
include_folders = ["10-Cursos", "20-Ideias", "40-Mapas", "50-Conteudo", "30-Projetos"]

# Diretórios técnicos e arquivos ignorados por segurança
exclude_folders = [".obsidian", "_sistema", ".trash", "90-Templates", ".git"]
Para processar notas com formatos livres, o extrator semântico local foi projetado de forma universal:
- Identifica títulos em cabeçalhos H1 ou no campo
titledo Frontmatter YAML. - Extrai resumos conceituais a partir de seções comuns (
## Introdução,## Resumo,## TL;DR,## Visão Geral) ou camposdescription/summarydo YAML. - Realiza fallback limpo para os parágrafos iniciais do texto, descartando metadados técnicos.
A CLI disponibiliza comandos específicos para controlar esse escopo sob demanda:
# Varre as pastas configuradas no c2b.toml
c2b link --all

# Força a varredura em todo o cofre Obsidian
c2b link --vault

# Indexa e interliga apenas uma pasta específica
c2b link --folder "50-Conteudo"

# Interliga uma nota específica em qualquer diretório do cofre
c2b link "50-Conteudo/Site/Site - course2brain.md"

# Simula as conexões sem alterar nenhum arquivo
c2b link --all --dry-runlink, interlink e linkar são aliases do mesmo comando.
Extensibilidade: suporte a múltiplas plataformas de cursos
A extensão do navegador foi projetada com o padrão Strategy para não ficar acoplada a nenhum layout ou fornecedor de LMS específico.
Os extratores atuais atendem ao Circle.so (utilizado pelo Tech Leads Club), ao Skilljar e à Udacity. Para suportar novas plataformas como Skool, Hotmart, Coursera, Udemy ou plataformas internas corporativas, basta criar uma subclasse de BaseExtractor na pasta extension/extractors/:
class SkoolExtractor extends BaseExtractor {
  get platformId() { return 'skool'; }
  get platformName() { return 'Skool'; }

  canHandle(url, doc) {
    return url.includes('skool.com');
  }

  async extract(doc) {
    return {
      platform: this.platformId,
      course_name: 'Nome do Curso',
      title: 'Título da Aula',
      captions_text: 'Legendas extraídas da tag track ou player...',
      notes_text: 'Conteúdo descritivo contido na página...',
      links: [{ texto: 'Repositório de Exemplo', url: 'https://github.com/.../exemplo' }],
      page_url: window.location.href,
      media_url: null,
    };
  }
}
O despachante (content.js) identifica dinamicamente qual extrator sabe processar a página ativa, extrai os campos e envia a carga útil padronizada ao motor local.
Sistema de plugins: automações e integrações locais
Para permitir que cada desenvolvedor adapte o fluxo às suas necessidades sem modificar o core da aplicação, o motor local em Python possui um sistema de ganchos desacoplado.
Scripts adicionados na pasta plugins/ (ou em ~/.config/c2b/plugins/) são carregados em tempo de execução pelo servidor local, com dois pontos de interceptação:
-
on_pre_process(payload, config) -> payload:
Executado assim que os dados chegam da extensão, antes da síntese pela IA. Permite enriquecer o payload, filtrar metadados, consultar APIs corporativas ou anexar caminhos de mídia física antes de gerar o resumo. -
on_post_save(note_path, payload, config) -> None:
Executado após a gravação da nota no Obsidian e atualização dos índices MOC. Permite disparar notificações de desktop, sincronizar arquivos com discos externos (NAS/SSD) ou acionar webhooks para automações (n8n, Slack, Telegram).
Exemplo de implementação de plugin:
def on_pre_process(payload: dict, config) -> dict:
    # Exemplo: normaliza metadados ou adiciona tags de contexto da empresa
    payload["empresa"] = "MinhaEmpresa"
    return payload


def on_post_save(note_path, payload: dict, config) -> None:
    # Exemplo: log ou acionamento de webhook
    print(f"Nota gravada com sucesso: {note_path}")
Como o diretório plugins/ é ignorado pelo controle de versão (.gitignore), automações com chaves de API internas, diretórios locais de rede ou regras privadas de negócio permanecem restritas ao computador do usuário.
Código aberto
O guia completo de instalação rápida, configuração do CLI (c2b serve, c2b init-vault, c2b link, c2b status) e orientações para criação de novos extratores estão documentados no repositório.
O projeto está disponível para testes, uso e contribuições:
- Repositório no GitHub: github.com/thyagoluciano/course2brain